📖 Cours Jour 17 · Maintenir le cluster : nœuds, mises à jour et sauvegarde d'etcd · 35 min
Mettre un nœud en maintenance
cordon, drain, uncordon
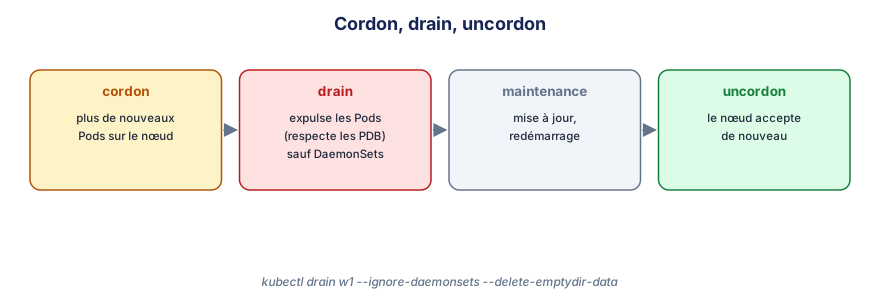
Il faut redémarrer w1 pour une mise à jour du noyau. Si on l'éteint brutalement, ses Pods disparaissent et ne sont recréés ailleurs qu'au bout de cinq minutes (le nœud passe NotReady, puis la teinte unreachable expulse les Pods après leur tolerationSeconds de 300 s). On fait donc les choses proprement :
k cordon w1                    # plus aucun NOUVEAU Pod ; les Pods présents restent
k get nodes                    # w1   Ready,SchedulingDisabled
k drain w1 --ignore-daemonsets --delete-emptydir-data
# evicting pod resaclub/api-6d8f9c7b5-x2k4p
# pod/api-6d8f9c7b5-x2k4p evicted
# node/w1 drained
# … maintenance, redémarrage …
k uncordon w1                  # le nœud accepte de nouveau des Pods
Commande
Effet
cordon
Marque le nœud unschedulable (teinte node.kubernetes.io/unschedulable:NoSchedule)
drain
cordon + expulsion de tous les Pods, en respectant les PodDisruptionBudgets
uncordon
Retire la marque. Ne ramène pas les Pods partis ailleurs
🔑 Les refus de drain
drain s'arrête et explique pourquoi :
cannot delete DaemonSet-managed Pods → --ignore-daemonsets (ils seraient recréés aussitôt sur le nœud) ;
cannot delete Pods with local storage → --delete-emptydir-data (le contenu des emptyDir sera perdu) ;
cannot delete Pods not managed by ReplicationController, ReplicaSet, Job, DaemonSet or StatefulSet → un Pod nu : --force le supprime définitivement, personne ne le recréera ;
Cannot evict pod as it would violate the pod's disruption budget → un PDB bloque : drain réessaie en boucle.
Cette leçon est réservée aux abonnés
Accédez à l'ensemble des cours, vidéos, ateliers, corrections et au certificat pour 29 € par mois sans engagement, ou 199 € par an.