📖 Cours Jour 18 · Dépanner : applications, plan de contrôle, nœuds et réseau · 50 min
Dépanner le plan de contrôle et les nœuds
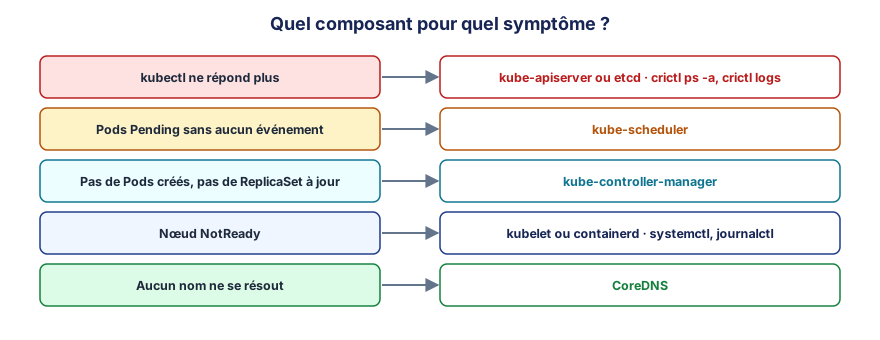
Le plan de contrôle
Composant en panne
Symptôme
kube-apiserver
kubectl : The connection to the server … was refused ou timeout
etcd
Le serveur d'API redémarre en boucle (il ne peut pas joindre etcd)
kube-scheduler
Les nouveaux Pods restent Pendingsans aucun événement
kube-controller-manager
Un Deployment créé n'a aucun ReplicaSet ; scale ne change rien ; rien ne se répare
CoreDNS
Les Pods ne résolvent plus aucun nom ; tout le reste fonctionne
kube-proxy (sur un nœud)
Les Services ne répondent pas depuis ce nœud ; les adresses de Pods, si
Quand kubectl répond encore :
k -n kube-system get pods -o wide
k -n kube-system describe pod kube-scheduler-cp1
k -n kube-system logs kube-scheduler-cp1
Quand le serveur d'API est tombé, on descend d'un étage :
sudo crictl ps -a | grep -E "apiserver|etcd"
# 7c1e…  kube-apiserver  Exited  4   ← il a redémarré 4 fois
sudo crictl logs 7c1e…
# Error: unknown flag: --etcd-servrs
sudo journalctl -u kubelet --since "5 min ago" | grep -i apiserver
sudo ls /var/log/pods/ | grep apiserver
⚠️ Un manifeste illisible
Si le YAML d'un Pod statique est invalide (indentation, tabulation), le kubelet ne crée même pas de conteneur : crictl ps -a ne montre rien. La trace est dans le journal du kubelet : journalctl -u kubelet | grep -i "kube-apiserver" affiche l'erreur d'analyse du fichier. Comparez avec votre copie de sauvegarde, ou avec un autre manifeste du même dossier.
Les erreurs typiques dans un manifeste du plan de contrôle : une option mal orthographiée, un chemin de certificat faux, un port faux (--etcd-servers=https://127.0.0.1:2380 au lieu de 2379), le chemin d'un kubeconfig faux pour le scheduler ou le controller-manager, une image inexistante, un mauvais command (kube-schedulerr).
Cette leçon est réservée aux abonnés
Accédez à l'ensemble des cours, vidéos, ateliers, corrections et au certificat pour 29 € par mois sans engagement, ou 199 € par an.